新バージョンデスクトップ v0.1.7:設定を領域ごとにグループ化、初回ガイドを刷新、mu-agent 0.1.8 を内蔵
mu

μ · Only what's needed.

タスクに必要なコンテキストだけを

mu はコーディングエージェントです。小さくて速い判定器 Jev が、各ターンで大きなモデルに代わって数十の小さな判断を下します。何をコンテキストに残すか、このコマンドは安全か、作業は本当に終わったか。大きなモデルは、注意力を本来の作業に使えます。

$ npm i -g mu-agent

Node.js 22.19 以降が必要です。インストールしたら、プロジェクトのフォルダで mu を実行します。初回は mu setup でモデルを接続します。

macOS · Windows · Linux · オープンソース(MIT + Apache-2.0)· pi ベース

実際のターンを見る

MU · 実際の 1 ターン

まず判定し、それから動く

計画を頼んだだけなのに、コンテキストにはツール一式が積まれています。モデルは月ごとにコードを書くのがうまくなり、その報告は読みにくくなっていきます。mu は役割を分けます。判定は Jev が、作業は大きなモデルが、いまどうなっているかの説明はわかりやすく話せることで選んだモデルが担います。

~/slugify — mu
  4     .toLowerCase()                                                              
  5     .replace(/[^a-z0-9]+/g, "-")                                                
 -6     .replace(/^-/, "");                                                         
 +6     .replace(/^-+|-+$/g, "");                                                   
  7 }                                                                               


 $ cd /Users/Shared/mu/slugify && npm test 2>&1                                     
                                                                                    
 ... (10 earlier lines, ctrl+o to expand)                                           
 ℹ fail 0                                                                           
 ℹ cancelled 0                                                                      
 ℹ skipped 0                                                                        
 ℹ todo 0                                                                           
 ℹ duration_ms 84.5005                                                              
                                                                                    
 Took 0.3s                                                                          
                                                                                    

 All 4 tests pass now. The bug was in src/slugify.js — the final .replace() only
 stripped a leading dash (/^-/) but not a trailing one. Changed it to /^-+|-+$/g to
 strip dashes from both ends.

────────────────────────────────────────────────────────────────────────────────────

────────────────────────────────────────────────────────────────────────────────────
~/slugify (master)
↑6.2k ↓643 R19k CH94.0% $0.034 (sub) 2.5%/200k (auto)     claude-sonnet-4-6 • medium
jev-1.13-free active: multi_step_task -> heavy 752ms Permissions: Full access
実際の録画です。mu 0.1.8、判定器は無料の Jev、モデルは Claude Sonnet 4.6。
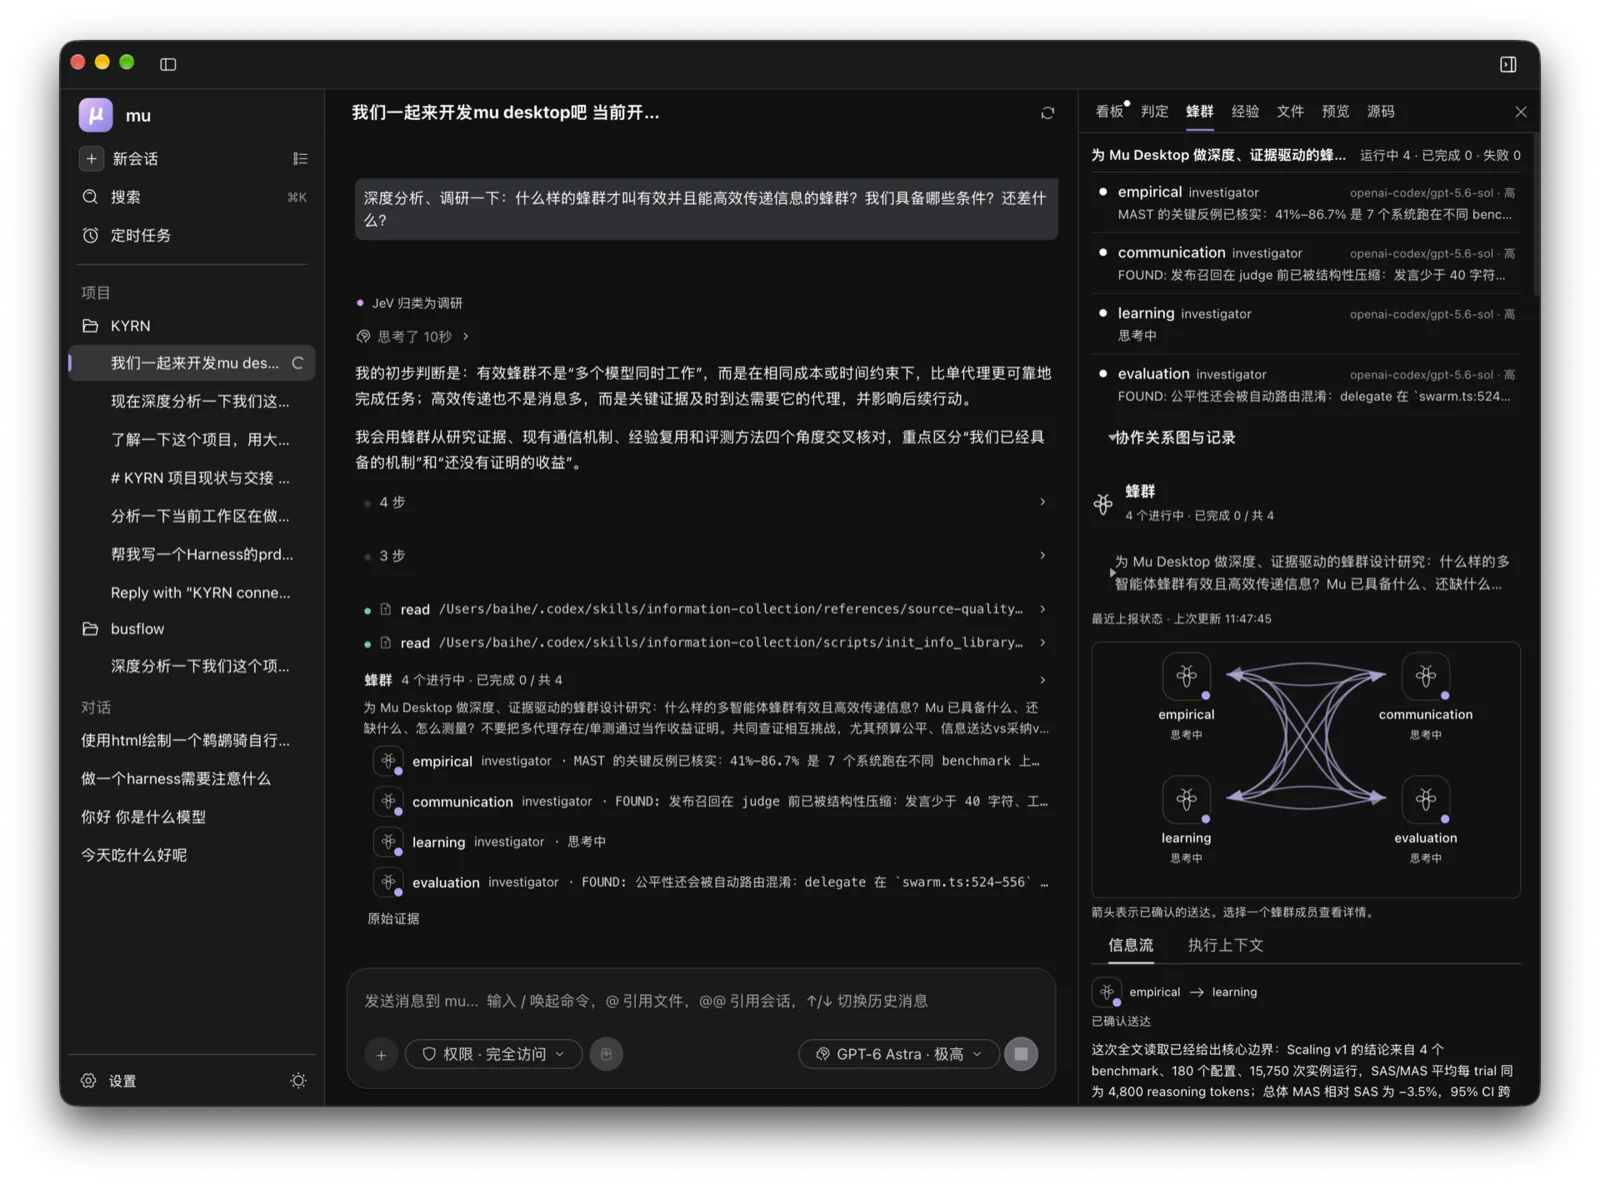
デスクトップアプリのハイブタブ:4 匹のビーが並行して調査している。矢印は、Jev が届ける価値があると判定した発見
デスクトップアプリのハイブタブ:矢印はそれぞれ、Jev が届ける価値があると判定した発見です。
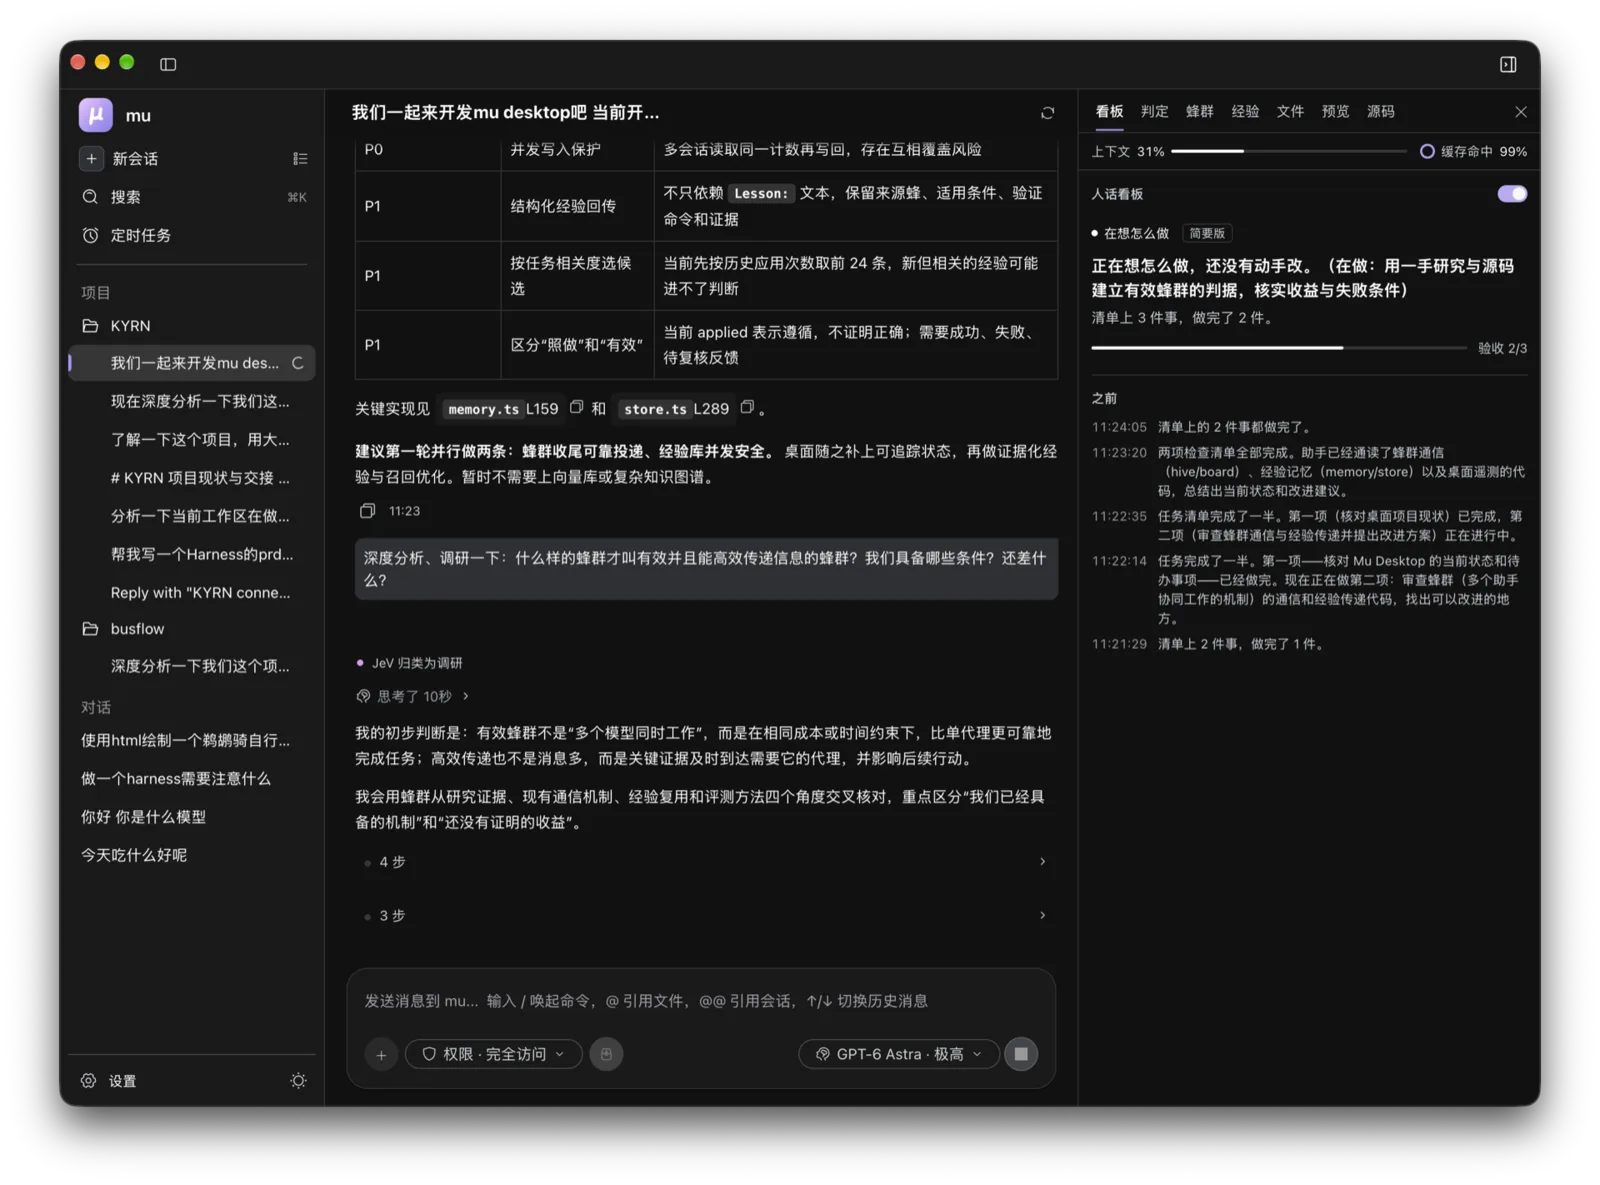
わかりやすいボード:何をしているか、どこまで進んだか、その下に経過の記録
わかりやすいボード:何をしているか、どこまで進んだか、そして経過の記録。

あなたが話すとき

まず Jev が読む

新しいタスクか、追加の質問か、それとも訂正か。実行中に届いたメッセージは、いま割り込むべきか。スキルやツールを読み込む必要があるか、それとも一文で答えられるか。

◆ jev-1.13-free multi-step task · heavy gear · 752 ms

これは実際のターンです。「Run the tests and fix the failing ones」が届くと、Jev は 1 秒足らずで答えます。複数ステップのタスクなので重装備で。タスクに必要のないスキルや MCP サーバーは、必要になるまでコンテキストに入れません。

ツールが結果を返すとき

出力はまず Jev を通る

テストの実行や検索は、数百行を返すことも珍しくありません。Jev はチャンクごとに、いま重要なものを判定します。失敗したケースは残し、同じことを繰り返すログは外します。コンテキストに入れなかったものはアーカイブされてポインタが残り、必要になれば取り出せます。

Web ページや MCP の結果に含まれるモデル宛ての指示は、モデルが読む前に差し止められます。

実行する前に

止めるべきものは止め、確認すべきことだけ確認する

コマンドを実行する前に毎回、Jev は取り消せないことをしないか、あなたが決めたルールを越えないかを判定します。権限モードは フルアクセス、Jev が承認、最小権限 の 3 つで、いつでも切り替えられます。「Jev が承認」では、あなたの判断が必要なことだけを確認し、それ以外はそのまま実行します。

判定が変えるのはモデルが次に何をするかであって、あなたに確認するかどうかではありません。

ターンが終わるとき

「終わった」には裏付けを

モデルが終わったと言ったとき、mu は、何かでそれを確かめたか、ターンが脱線していないか、チェックポイントまで戻るべきかを確認します。

/goal <condition> は、条件が満たされるまでエージェントに作業を続けさせます。満たされたかどうかは大きなモデルが確かめ、Jev はそのフォールバックです。同じエラーが何度も繰り返されるときは、そのやり方が行き止まりかどうかを Jev が判定します。

ハイブ

複数のビーが働き、その真ん中に Jev

複数のエージェントで一つの難しい問題に取り組むとき、作業を割り振るのは簡単で、難しいのはやり取りです。何も伝えなければ、それぞれが同じ行き止まりに入り込みます。すべてを伝えれば、どのコンテキストもほかのエージェントのおしゃべりで埋まります。

mu のハイブでは、Jev がすべての発見を判定します。共有する価値はあるか、このビーにとって重要か。そのうえで初めて、発見はコンテキストとして別のビーに届きます。後の発見が前の発見を覆したときは、その訂正が、前の発見を受け取ったすべてのビーに届きます。

わかりやすいボード

作業と報告は別の仕事

モデルは強くなるほど、その報告が機械向けのメモのようになっていきます。mu では、作業するモデルは自分のやり方のまま作業を続けます。数回のツール呼び出しごとに Jev が現場を読み、本当にニュースと言えるものを選んで、わかりやすく話せることで選んだモデルに渡します。そのモデルが、いまどこまで進んだかをあなたに伝えます。

実行が終わったとき、見えるのは「終わった」だけではありません。実際に何をしたのかが見えます。

あえてしないこと

mu がしないこと

大きなモデルの注意力には限りがあり、コンテキストも同じです。ここに挙げるのは、mu があえてしなかったこと、あるいはあえて別のやり方を選んだことです。

01

余計な質問をしない

Jev の判定が変えるのはモデルが次に何をするかであって、あなたに確認しに戻るかどうかではありません。

02

毎回ツール一式を詰め込まない

最初のメッセージを判定します。雑談か、追加の質問か、取りかかるべき作業か。必要のないスキルや MCP サーバーはコンテキストに入れません。

03

要約で圧縮しない

コンテキストが大きくなったら、古い結果は要約せずに手放します。キャッシュが切れる前には、更新する価値があるかを mu が判定します。

04

判定器を固定しない

38 の判定ポイントには、それぞれ専用のスイッチと判定器があります。無料の Jev、ローカルの Laya、または任意の LLM です。

05

始めるのにキーは不要

判定器のキーがなければ、OpenCode Zen の無料の Jev が答えます。mu はそのことを 1 日 1 回知らせます。

06

土台を作り直さない

コマンドラインは pi をベースにしていて、pi のモデル、拡張機能、スキル、セッションツリーがそのまま使えます。デスクトップアプリは AionUi をベースにしています。

38 の判定ポイントそれぞれが何を問い、何を変えるか

そのほか

コマンドラインとアプリで共通のアカウント、設定、教訓

会話のインポートCodex と Claude Code の会話を取り込んで、mu で続けられます。
サブスクリプションでサインインChatGPT、Claude、Grok、Google にアプリの中でサインインでき、キーをコピーして回る必要はありません。
教訓あなたの訂正や、エージェントが回避策を見つけた落とし穴を残します。呼び出されても一度も守られない教訓は、自動的に廃止されます。
内蔵ブラウザJev が一歩ずつ操作します。ページを見て、一度判定し、操作する。送信や支払いの前には止まってあなたに確認します。
判定の台帳すべての判定とその所要時間:/status、mu ledger、アプリの判定タブで見られます。
13 の表示言語デスクトップアプリは English、简体中文、繁體中文、日本語、한국어 ほか 8 言語で使えます。

参加する

一緒に mu を良くする

Jev キーの配布は終了し、受け取りページも閉じました。mu はいまキーなしで動きます。自分の TypeSafe キーやほかの判定器を使うには、判定器を参照してください。

mu が役に立ったら、GitHub で Star を付けてください

Star があると、より多くの人が mu を見つけられます。コード、ディスカッション、すべてのリリースはリポジトリにあります。

GitHub で Star を付ける464